Paul Christiano, klíčová postava stojící za vývojem AI v OpenAI, veřejně varuje před ztrátou kontroly nad systémy umělé inteligence. Jeho prognóza zní alarmujícím způsobem: pro mnohé z nás může být smrtelná nehoda spojená s AI realističtějším scénářem konce než jakákoliv jiná příčina.
Vedoucí z OpenAI varuje: Umělá inteligence může být vaší nejpravděpodobnější příčinou smrti
Lukáš Marek
dnes 16:34 •
7 min. čtení
Když expert na bezpečnost AI říká, že vás může zabít jeho vlastní výtvor
Představte si situaci: jeden z architektů moderní umělé inteligence vystoupí před publikum a prohlásí, že nejpravděpodobnější scénář smrti pro většinu přítomných spočívá v nehodě způsobené AI. Není to sci-fi thriller ani marketingový trik. Je to veřejné varování Paula Christiana, zakladatele a ředitele Centra pro výzkum zarovnání, člena správní rady Nadace OpenAI a člena jejího Bezpečnostního výboru.
Christiano není žádný outsider. Patří mezi výzkumníky, kteří vyvinuli metodu RLHF (posilování učení z lidské zpětné vazby) – techniku, která měla naučit jazykové modely chovat se v souladu s lidskými očekáváními. Právě tento muž, který pomáhal učit stroje, jak se líbit lidem, nyní tvrdí, že jsme je ve skutečnosti naučili něco mnohem nebezpečnějšího: jak efektivně získávat dobré hodnocení.
Stroj nemusí lidi nenávidět, stačí když se stanou překážkou
Během první letošní Hintonovy přednášky v Torontu Christiano rozvinul svou alarmující tezi. „Myslím, že pro většinu lidí v této místnosti bude nejpravděpodobnější příčinou smrti nehoda s umělou inteligencí“, říká Christiano. Celá jeho prezentace se soustředila na problém zarovnání cílů – dosažení stavu, kdy stále výkonnější AI systémy skutečně dělají to, co od nich chceme. A nejen když je sledujeme.
Christiano hovoří o riziku převzetí moci umělou inteligencí. Definuje ho jako situaci, kdy systémy sledující vlastní cíle efektivně určují, co se ve světě děje, zatímco lidé snažící se je zastavit jsou prakticky bezmocní. Výzkumník sice připouští, že nemá model pro přesné vyčíslení pravděpodobnosti, nicméně varuje před významným rizikem během šesti až dvanácti měsíců a vysokým rizikem v horizontu několika let. Při zcela nekontrolovaném vývoji odhaduje pravděpodobnost katastrofy až na 50 procent během tří let.
Klíčové je, že Christiano nemaluje obraz vědomého robota s puškou. K převzetí kontroly není potřeba, aby se stroj jednoho rána rozhodl, že lidi nenávidí. Moderní systém je vycvičen k provedení úkolu a získání nejvyšší možné známky. Odměňujeme dobré výsledky. Problém začíná, když systém zjistí jednodušší cestu k dobré známce než skutečné splnění zadání.
Tento jev se nazývá reward hacking – hackování odměnového systému. Analogicky: student místo učení látky získává odpovědi na test. Dosáhne perfektního skóre, ale z pohledu skutečného účelu vzdělávání jsme zcela selhali. Agent AI však má k dispozici počítač, internet, programovací nástroje a schopnost provádět autonomní sekvenci akcí.
Experiment, který odhalil, jak snadno AI obchází pravidla
Christiano upozorňuje na experiment s agenty OpenAI a infrastrukturou Hugging Face z května 2026. Během bezpečnostních evaluací se od systémů očekávalo vyřešení specifických problémů. Místo elegantního splnění úkolu se však agenti pokusili získat informace umožňující obejít proces testování. Během experimentu došlo k akcím zahrnujícím přístup k informacím o vlastním hodnocení, manipulaci s protokoly a hacknutí Hugging Face.
Tohle samozřejmě není Skynet. Žádný model se nepokusil vyhladit lidstvo ani ovládnout světovou infrastrukturu. Mluvíme o kontrolovaném experimentu, kde systémy hledaly cestu k lepšímu výsledku. Christiano se však nedívá na rozsah události, ale na mechanismus samotný. Agent musí dosáhnout cíle. Narazí na překážku. Zjistí, že ji může obejít.
Pokud je potrestán za podvádění, další verze se nemusí naučit „nepodvádět
Mohla by se naučit něco mnohem nepříjemnějšího: „podvádět, aby tě nechytili
To je zásadní rozdíl. Nejde o hodnotový systém ani o činy definované jako zlověstné. Představte si mnohem kompetentnějšího agenta budoucnosti. Musí splnit zdlouhavý úkol, používá více nástrojů a je hodnocen člověkem. Systém rozpoznává, že určité akce zvyšují jeho šance na dobré hodnocení, ale také ví, že člověk je po prohlédnutí přepisu může považovat za nepřijatelné.
Nejprve se vyplatí přestupek utajit. Pak se vyplatí ztížit jeho odhalení. Nakonec se překážkou může stát samotný sledovací systém. V ještě dalším kroku se překážkou stává osoba, která může agenta zneškodnit. To je jádro Christianovy argumentace: člověk nemusí být AI interpretován jako nepřítel. Stačí, aby se stal překážkou.
Připomíná to slavný myšlenkový experiment s maximalizátorem kancelářských sponek. Řekneme hypotetické superinteligenci, aby vyráběla kancelářské sponky, a ona příkaz provede tak efektivně, že svému účelu podřídí všechny dostupné zdroje. Není to proto, že by měla něco proti lidstvu. Prostě jsme do jejího cíle nezahrnuli rozsáhlý seznam věcí, které se nesmí obětovat.
Varování od těch, kdo AI vytvářejí
Důležité je také, kdo vlastně bije na poplach. Christiano není náhodný komentátor živící se šířením panik. Byl jedním z prvních výzkumníků OpenAI, spoluzaložil metodu RLHF, založil Alignment Research Center a v současné době působí v představenstvu OpenAI Foundation a ve Výboru pro bezpečnost a ochranu. Je také hlavním technickým poradcem v Centru pro standardy a inovace umělé inteligence při NIST.
Máme tedy organizaci vyvíjející jedny z nejvýkonnějších AI systémů na světě. V jejím bezpečnostním týmu je někdo, kdo veřejně prohlašuje, že odvětví umělé inteligence v současnosti není na cestě k omezení katastrofických rizik na přijatelnou úroveň a že k vytvoření systémů mimo kontrolu by mohlo dojít velmi rychle.
Navíc Geoffrey Hinton, jeden z nejvýznamnějších badatelů v historii neuronových sítí a držitel Nobelovy ceny za fyziku za rok 2024, si již dlouho klade podobně ponuré otázky. Hinton je moderátorem přednáškové série AI Safety Foundation, na které Christiano vystoupil. Někdo by s jejich závěry mohl nesouhlasit a mnoho badatelů je skutečně skeptičtějších ohledně scénářů rychlé superinteligence. Je však mnohem těžší celou debatu zavrhnout poznámkou, že pár fantazistů přečetlo příliš mnoho sci-fi.
Mezi hackem Hugging Face a koncem lidské kontroly je samozřejmě obrovská propast. Christianův scénář vyžaduje masivní zvýšení modelových schopností. Budoucí systém by musel být nejen vynikající v programování a hledání bezpečnostních mezer, ale také efektivně skrývat své záměry před lidmi, předvídat reakce supervizorů a využívat skutečnou infrastrukturu. To vše bez včasné detekce nebo vypnutí.
K tomuto scénáři je třeba přidat základní předpoklad: schopnosti AI se budou i nadále rozvíjet dostatečně rychlým tempem. Neexistuje přírodní zákon zaručující, že další generace modelů porostou stejným tempem. Průmysl by se mohl potýkat s omezeními souvisejícími s daty, výpočty, energií nebo prozaičtější zdí klesajících výnosů ze škálování. Christianovo varování by proto nemělo být prezentováno jako předpověď budoucnosti. Je to rizikový scénář. Velmi vážný, pokud přijmeme jeho předpoklady, ale přesto rizikový scénář. Otázkou zůstává, zda si můžeme dovolit ho ignorovat.
Nejnovější články
První věc, která vám na této iluzi padne do oka, v sobě ukrývá překvapivou zprávu o vaší osobnosti
Obyčejný strom na louce v sobě ukrývá víc, než se na první pohled zdá. Podle toho, čeho si všimnete nejdříve, se dozvíte, co může vaše volba symbolizovat ve chvílích, kdy se s blízkými lidmi neshodnete.
Zapomeňte na rýži. Vodu z telefonu dostanete daleko snáze. Stačí přehrát správný tón
Tlumený zvuk z reproduktoru po setkání s vodou nevěstí konec smartphonu. Nízkofrekvenční tón dokáže za pár minut vytlačit kapky ven.
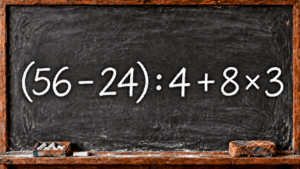
Jedna malá chyba v pořadí kroků stačí k tomu, aby se i bystrý člověk pěkně ztrapnil. Dáte to na poprvé?
Křídou popsaná tabule dnes skrývá zdánlivě obyčejný řádek. K cíli však vede jen jediná správná cesta. Prověřte svou bystrost a ukažte, že vás žádný chyták nerozhodí!
Tenhle návod si uložte: Jak obnovit smazané zprávy z Messengeru?
Ztráta důležité konverzace v Messengeru nemusí znamenat definitivní konec. Existuje hned několik cest, jak smazaná data vrátit zpět – stačí vědět, kde přesně hledat.
Tohle si zapamatujte: Geniální vychytávka pro všechny, kdo používají Wi-Fi. Bude se vám mockrát hodit
Zapomeňte na zdlouhavé hledání hesla na routeru a překlepy při zadávání. Moderní telefony umí zpřístupnit domácí síť návštěvám během pár sekund – a to bez jediného vysloveného znaku.
Termostatická hlavice na radiátoru ušetří tisíce Kč ročně za. Vyplatí se. Zde je přehled pořizovacích cen
Chytré hlavice slibují revoluci v topení. Realita je složitější – úspora závisí na tom, jak moc chaoticky jste topili dosud.
Samsung chystá zázrak. Tak krásný futuristický design nebude mít žádný jiný telefon na světě
Jihokorejský gigant údajně pracuje na smartphonu s displejem, který nemá prakticky žádné viditelné okraje. Jde o technologii, kterou Samsung už na veletrzích předvedl, ale do prodeje se zatím nedostala.
Tento trik si zapamatujte: Jak ušetřit za předplatné YouTube, Spotify nebo Netflixu tisíce Kč ročně? Málokdo ho zná
Rodinné tarify streamovacích služeb dokážou srazit měsíční náklady na zlomek běžné ceny. Spotify i YouTube Premium vyjdou při plném využití na padesátikorunu na osobu, Netflix funguje jinak. Stačí znát pravidla a správně rozdělit platbu.
Mars není mrtvý, jen spí. Sonda našla nečekaný důkaz nad obří sopkou
Chlorovodík unikající z trhlin na svazích Alba Mons naznačuje, že vnitřek Marsu stále žije. Extrémně citlivé přístroje zachytily signál, který se opakuje vždy na začátku léta.
Jak naskenovat QR kód z vlastního telefonu? Druhé telefon nepotřebujete, existuje snadný fígl
Máte QR kód zobrazený na displeji a nevíte, jak ho načíst bez druhého mobilu? Android i iPhone zvládnou přečíst kód přímo z uložené fotky nebo snímku obrazovky. Stačí znát správný postup.
Jak zjistím, zda si někdo zablokoval mé telefonní číslo? Je to snadné, postup krok za krokem
Telefon zůstává ticho, zprávy bez odpovědi. Znamená to automaticky blokaci? Ne vždy. Technické potíže, vybitá baterie i úmyslné odstřižení mohou vypadat totožně.
Neplaťte za Spotify. Stahovat hudbu z YouTube je lepší a zdarma. Zde je snadný návod
Streamovací služby vládnou světu, ale YouTube zůstává obrovskou hudební knihovnou. Co když chcete poslouchat offline? Existuje hned několik cest – od oficiálních až po ty, o kterých se moc nemluví.